메모리 버퍼풀 사례로 알아보는 데이터베이스 특성(영속성, 원자성 등)
개요
메모리에 대한 전략을 알아보았고, 실제 사례를 통해 우리가 어떻게 페이지를 교체하는지에 대해서 알아볼 수 있었다. 실제 practical 한 예시를 들기 위해서 현대의 데이터베이스 시스템을 기반으로 이를 정리해보자.
메모리 계층 개요
그 전에 앞서서, 완벽히 추상화할 수는 없지만 우리는 데이터베이스 시스템에서 쓰이는 메모리 계층을 아래와 같이 분할할 수 있다.
- Write Buffer: 쓰기 작업을 일시적으로 보관하거나 데이터 페이지를 수정하는 공간.
- Read Cache: 디스크에서 읽은 데이터를 재사용하기 위한 공간.
- OS Page Cache: 운영체제가 파일 I/O를 위해 관리하는 메모리.
write()가 성공해도 데이터가 여기에만 존재할 수 있음.
여기서 중요한 것은 이러한 세 개의 계층이 각 구현에 따라 없을 수도 있고, read + write 형식으로 존재할 수도 있다. 이는 각 데이터베이스 시스템이 어떤 것에 “집중”하는 지에 따라 계층 구조가 변경된다.
또한, 영속성을 보장하기 위해 위와 별개로 트랜잭션 시에는 WAL(Write Ahead Log)를 기록할 수도 있다. 이는 메모리 계층은 아니지만, 영속성 보장을 위해 지원하는 컴포넌트에 가깝다. 주요 사례를 위해 우리는 ClickHouse, RocksDB, PostgreSQL을 살펴보자.
전체 비교
실제 개괄은 아래 표와 같다. 당장은 어렵겠지만 하나 하나 씩 풀어보자.
| 항목 | ClickHouse (MergeTree) | RocksDB | PostgreSQL |
|---|---|---|---|
| 스토리지 구조 | Immutable columnar parts | LSM-Tree / SST | Heap pages + Index |
| 주요 Write Buffer | Insert 처리 블록, Async Insert Buffer | MemTable | Shared Buffers |
| WAL | 일반 MergeTree INSERT에 없음 | 있음 | 있음 |
| 쓰기 방식 | 새로운 Part 생성 | MemTable에 추가 | 기존 Page 수정, 새 Tuple 기록 |
| 디스크 적재 | Part 파일 생성 | MemTable Flush → SST | Dirty Page Writeback |
| 백그라운드 작업 | Part Merge | Flush / Compaction | Background Writer / Checkpoint |
| 주요 Read Cache | OS Page Cache, Mark Cache | Block Cache | Shared Buffers |
| 트랜잭션 | 제한적인 INSERT 원자성 | WriteBatch / TransactionDB | 완전한 ACID 트랜잭션 |
| Durability 핵심 | Part 파일의 영속화, 복제 및 설정 | WAL Sync 또는 SST 영속화 | WAL Flush at Commit |
OLTP
OLTP(Online Transaction Processing)는 기본적으로 쓰기 및 읽기에서의 실시간 및 원자성과 트랜잭션 처리를 지원하는 데이터베이스 시스템이다. 이전부터 이어져 온 시스템인만큼 이론적 깊이가 깊고, 그 구조가 잘 알려져 있다.(즉, 추상화가 잘 되어 있다.)
PostgreSQL
PostgreSQL은 MySQL만큼 대표적인 사용 사례이다. PostgreSQL은 기본적으로 Page-oriented 구조로 디스크에 Heap 에 페이지 단위로 저장하며, B+Tree를 포함한 여러 인덱스를 지원한다.
Write Buffer(Shared Buffers)
PostgreSQL은 데이터 페이지를 관리하는 Shared Buffers와 변경 로그를 보관하는 WAL Buffers를 사용한다. MVCC에 따른 새 Tuple 버전은 데이터 페이지에 반영되고, Shared Buffers는 Write Buffer와 Read Cache 역할을 함께 한다. 변경된 페이지는 dirty 상태가 되며, 다음 구성요소가 디스크 쓰기를 수행할 수 있다. [1], [2]
| 구성요소 | 역할 |
|---|---|
| Background Writer | Dirty Page를 미리 기록해 재사용 가능한 Buffer 확보 |
| Checkpointer | Checkpoint에 필요한 Dirty Page 기록 및 동기화 |
| Backend Process | Buffer 확보가 필요할 때 직접 Dirty Page 기록 가능 |
여기서 중요한 것은 Shared Buffers 에서 파일 쓰기를 요청했다고, 실제 디스크에 저장됨은 보장할 수 없다. OS Page Cache 로 복사된 값이므로 이를 위해서는 WAL가 필요하다.
WAL(Durability)
영속성의 핵심은 WAL을 영구 저장장치에 동기화하는 것이다. 기본적인 동기 커밋은 트랜잭션의 WAL이 영속화된 후 성공을 반환한다. 반면 synchronous_commit=off로 설정하면 WAL의 영속화를 기다리지 않고 커밋을 반환할 수 있다. 지연은 줄지만, 장애 시 최근 커밋이 유실될 수 있다는 trade-off가 있다. [3]
여러 트랜잭션이 동시에 커밋하면 Group Commit으로 WAL 동기화 비용을 나눌 수 있다. 이는 단순히 백그라운드 프로세스가 모든 커밋을 처리한다는 뜻은 아니며, 한 번의 WAL flush가 여러 커밋을 함께 영속화하는 방식이다. [2]
다만, 동시 커밋이 적으면 Group Commit으로 비용을 나눌 기회도 줄어든다. 동기화 방식은 wal_sync_method에 따라 fdatasync() 등으로 달라지며, 단순히 OS Page Cache에 쓰는 것과 영구 저장장치까지 동기화하는 것은 구분해야 한다. [2]
Read Cache(Shared Buffers + OS Page Cache)
PostgreSQL은 Shared Buffers + OS Page Cache를 이용한 2계층 캐싱을 지원한다. [4] 참고로 MySQL InnoDB의 데이터 파일 캐싱은 innodb_flush_method와 플랫폼에 따라 달라진다. MySQL 8.4의 Unix 환경에서는 지원되는 경우 O_DIRECT가 기본값이며, 이때 데이터 파일 I/O가 OS Page Cache를 우회한다. [5]
Read Cache의 페이지 크기는 8KiB이고, Replacement Policy는 Clock-sweep을 이용한다. Query Result Cache가 아니라, 실제 Heap Page, Index Page를 통해 Spatial Locality 가정을 기반으로 캐싱 전략을 가져간다.
또한, 대규모 Sequential Scan 등에서는 작은 Buffer Ring을 재사용해 Shared Buffers의 기존 페이지가 대량으로 밀려나는 것을 줄인다. 이 Ring은 쿼리 결과를 저장하는 별도 캐시가 아니라, 스캔에 사용하는 데이터 페이지 버퍼를 제한적으로 재사용하는 전략이다. [1]
RocksDB
RocksDB의 경우는 LSM-Tree 기반의 Key-Value Store Engine 이다. 따라서, Write Buffer와 Read Cache를 명확하게 구분한다.
LSM-Tree는 MemTable에 쓰기를 모으고 정렬된 파일로 내보내는 구조로 쓰기 성능을 높이는 대신, Compaction과 읽기 증폭 등의 비용을 부담한다. SQL이나 Join 지원 여부는 LSM-Tree 자체의 제약이라기보다 그 위에 어떤 쿼리 계층을 구성했는지에 달려 있다. 여기서는 RocksDB라는 Key-Value Store Engine에 한정해서 살펴보겠다.
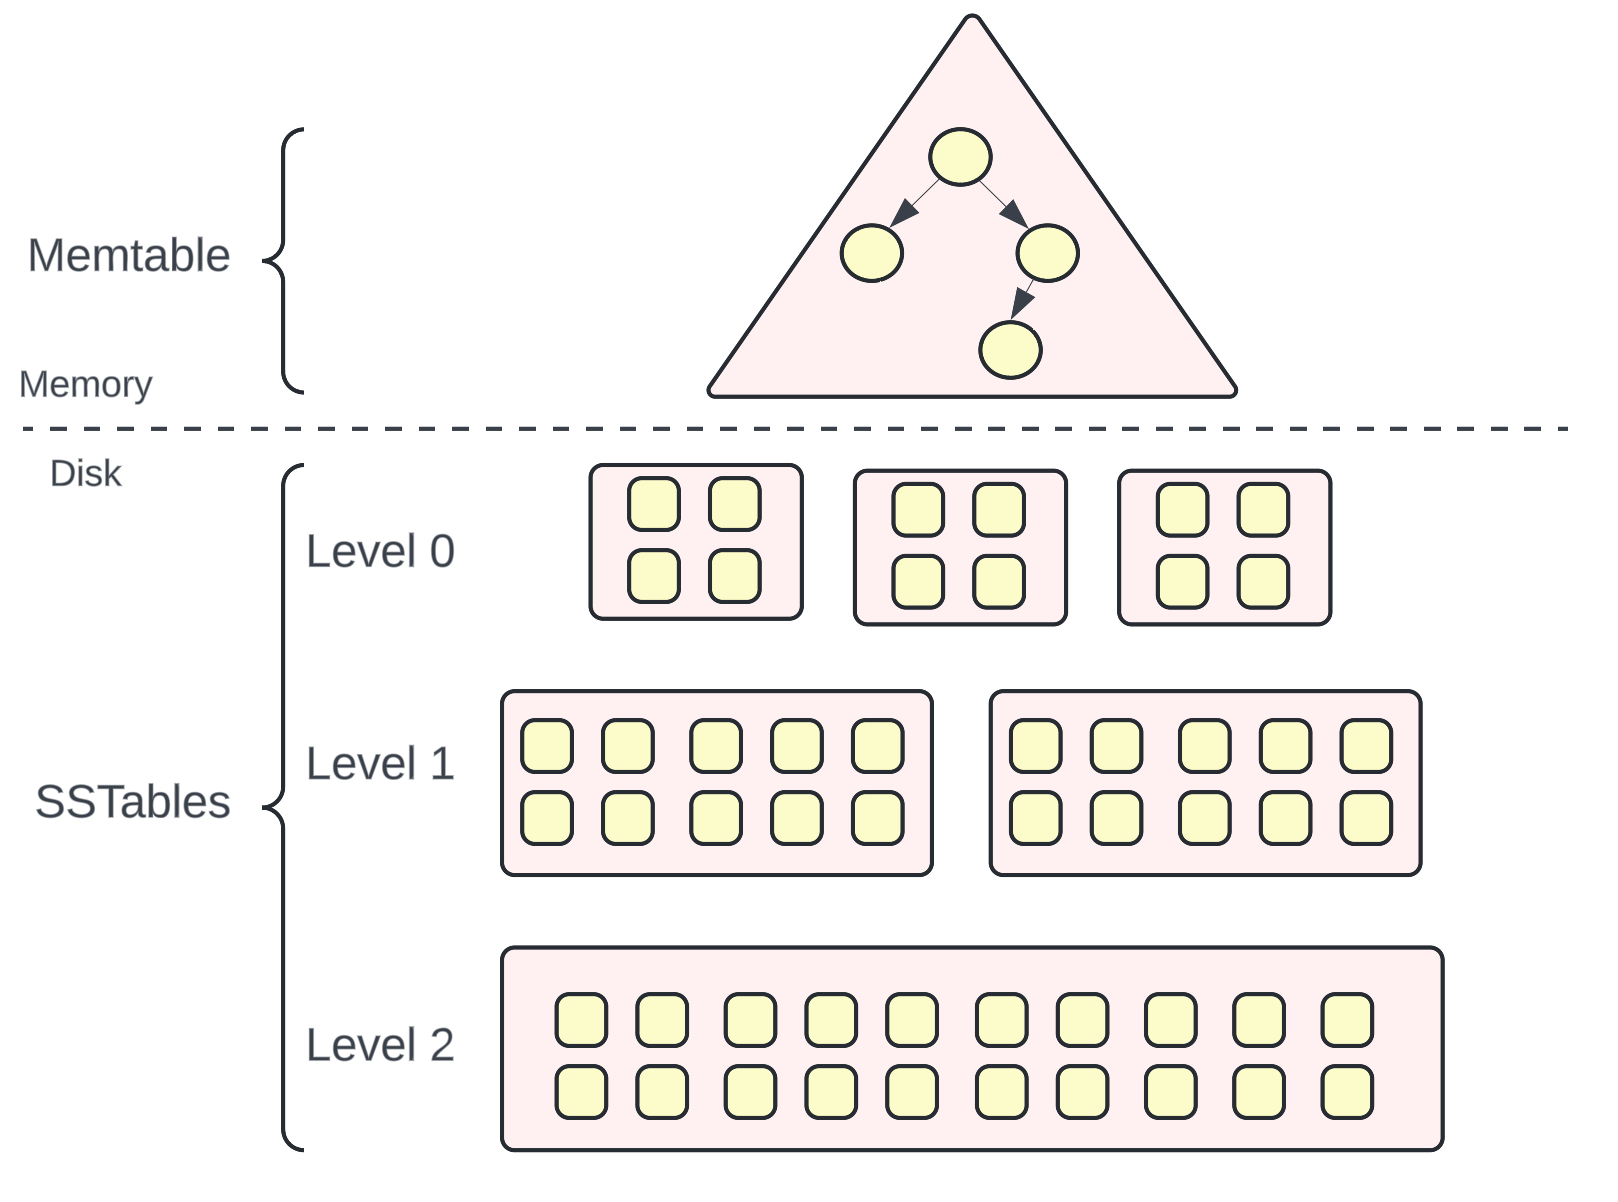
RocksDB는 MemTable과 SSTable을 사용한다. MemTable은 기본적으로 SkipList를 사용하며 다른 자료구조도 선택할 수 있다. 쓰기는 먼저 메모리의 MemTable에 반영되고, 조건이 충족되면 이를 Immutable MemTable로 전환한 뒤 SSTable로 flush한다. Leveled Compaction에서는 여러 레벨의 SSTable을 병합·정리하는 작업이 뒤따른다.
Write Buffer(MemTable)
RocksDB의 일반적인 쓰기는 WAL 기록과 MemTable 반영으로 이루어진다. 여러 변경을 원자적으로 묶는 WriteBatch와 별도로, 트랜잭션 API는 잠금 기반의 TransactionDB와 커밋 시 충돌을 검사하는 OptimisticTransactionDB를 제공한다. 낙관적 동시성 제어가 모든 쓰기의 기본인 것은 아니다. 자세한 트랜잭션 패턴은 RocksDB 위키를 참고하자. [6]
기본적으로 MemTable의 크기가 임계값에 도달하거나, WAL 크기 등의 조건이 충족되면 Flush 한다. 이 때 저장하는 단위는 SSTable 이며, 정렬된 불변 파일의 형태로 저장된다. 이후 Compaction 에서는 여러 SST를 병합하고, 오래된 Version 의 Tombstone(logical delete)을 정리하는 등의 작업이 포함된다.
WAL(Durability)
WAL을 통해 RocksDB 역시 영속성을 확보할 수 있다. 다만 기본 쓰기 옵션은 WriteOptions::sync=false이므로, 성공 응답이 영구 저장장치까지의 동기화를 뜻하지는 않는다. WAL을 활성화하고 기본 manual_wal_flush=false를 사용하는 경우 OS에 전달된 로그는 프로세스만 종료되는 장애에서는 복구할 수 있지만, 시스템 장애나 전원 손실 시 최근 쓰기가 유실될 수 있다. sync=true는 WAL 동기화까지 기다린다. [7]
이 의미가 절대 영속성을 포기한 엔진이라고는 생각하지말자, 결국 Write Latency와 Durability의 trade-off를 이해하고 이를 어플리케이션 사용자에게 열어주는 방식이다. [8] 역시 여기서도 Group Commit 및 Background WAL Writer 를 이용한 적절한 제공도 가능하다.
한 발짝 더 나아간다면, 복제와 일관성 수준까지 다루는 Cassandra도 좋은 공부 거리이다. Cassandra는 Dynamo의 분산 설계를 참고하지만 RocksDB 위에 복제를 얹은 시스템은 아니다. 로컬 저장의 영속화와 복제본 수, 쓰기 성공을 반환하는 일관성 조건은 별도로 구분해야 한다. [9]
Read Cache(Block Cache)
RocksDB는 Read Path에서 MemTable을 확인하고, SSTable을 읽을 때 Block Cache를 이용한다. Block Cache는 일반적으로 압축이 해제된 SST 데이터 블록을 저장하고, Buffered I/O에서는 OS Page Cache도 활용한다. [10] 기본 Block Cache는 과거 LRU였지만, 10.7.0부터 명시적인 캐시를 지정하지 않은 기본 구성에서는 HyperClockCache로 변경되었다. [11]
- Block Cache 라는 점에서도 알 수 있듯이 여전히 Spatial Locality 을 지원한다.
- OS Page Cache는 파일의 바이트를 OS 페이지 단위로 캐싱한다. SSTable이 압축되어 있다면 압축된 파일 데이터를 캐싱하는 셈이다. [10]
- LRU와 HyperClockCache 모두 시간적 지역성을 활용한다. HyperClockCache의 주요 이점은 높은 동시성에서 캐시 관리의 경합과 CPU 비용을 줄이는 데 있다. [11]
또한, PostgreSQL과 같이 Sequential Scan에 대해서는 읽은 SST 데이터 블록을 캐시에 새로 넣지 않는 ReadOptions::fill_cache=false를 제공하여 Cache Pollution 을 막을 수도 있다.
OLAP
이제 OLAP(Online Analytical Processing)다. OLAP는 기본적으로 OLTP와 다르게 대규모의 데이터를 빠르게 읽고, 수많은 큰 테이블 간의 Join 등을 지원해야 하는 경우 강력한 병렬성(MPP, Massive Parallel Processing)과 열 기반 저장(Columnar Data Format)을 이용하여 이를 제공한다. 대표적인 게 엄청 많지만 이번 장에서는 ClickHouse 만을 한정한다.
또 하나의 특징은 데이터가 이벤트와 같은 형식으로 Insert-Only 인 Use-Case 가 많다는 점이다. 수천만 개의 이벤트의 퍼널 분석이나, 코호트 분석 등을 통해 고객이 어느 구간에서 이탈하는지 리텐션은 얼마인지를 구한다고 생각해보고 이를 어떻게 구현할지 고민해봐라.
ClickHouse
ClickHouse는 OLAP 시스템으로 직관적인 구조와 관리 용이성으로 많은 레퍼런스를 가지고 있다. 여기서 중요한 건, MergeTree 라는 개념인데, 아래 Insert 케이스를 기반으로 예시를 보아보자.
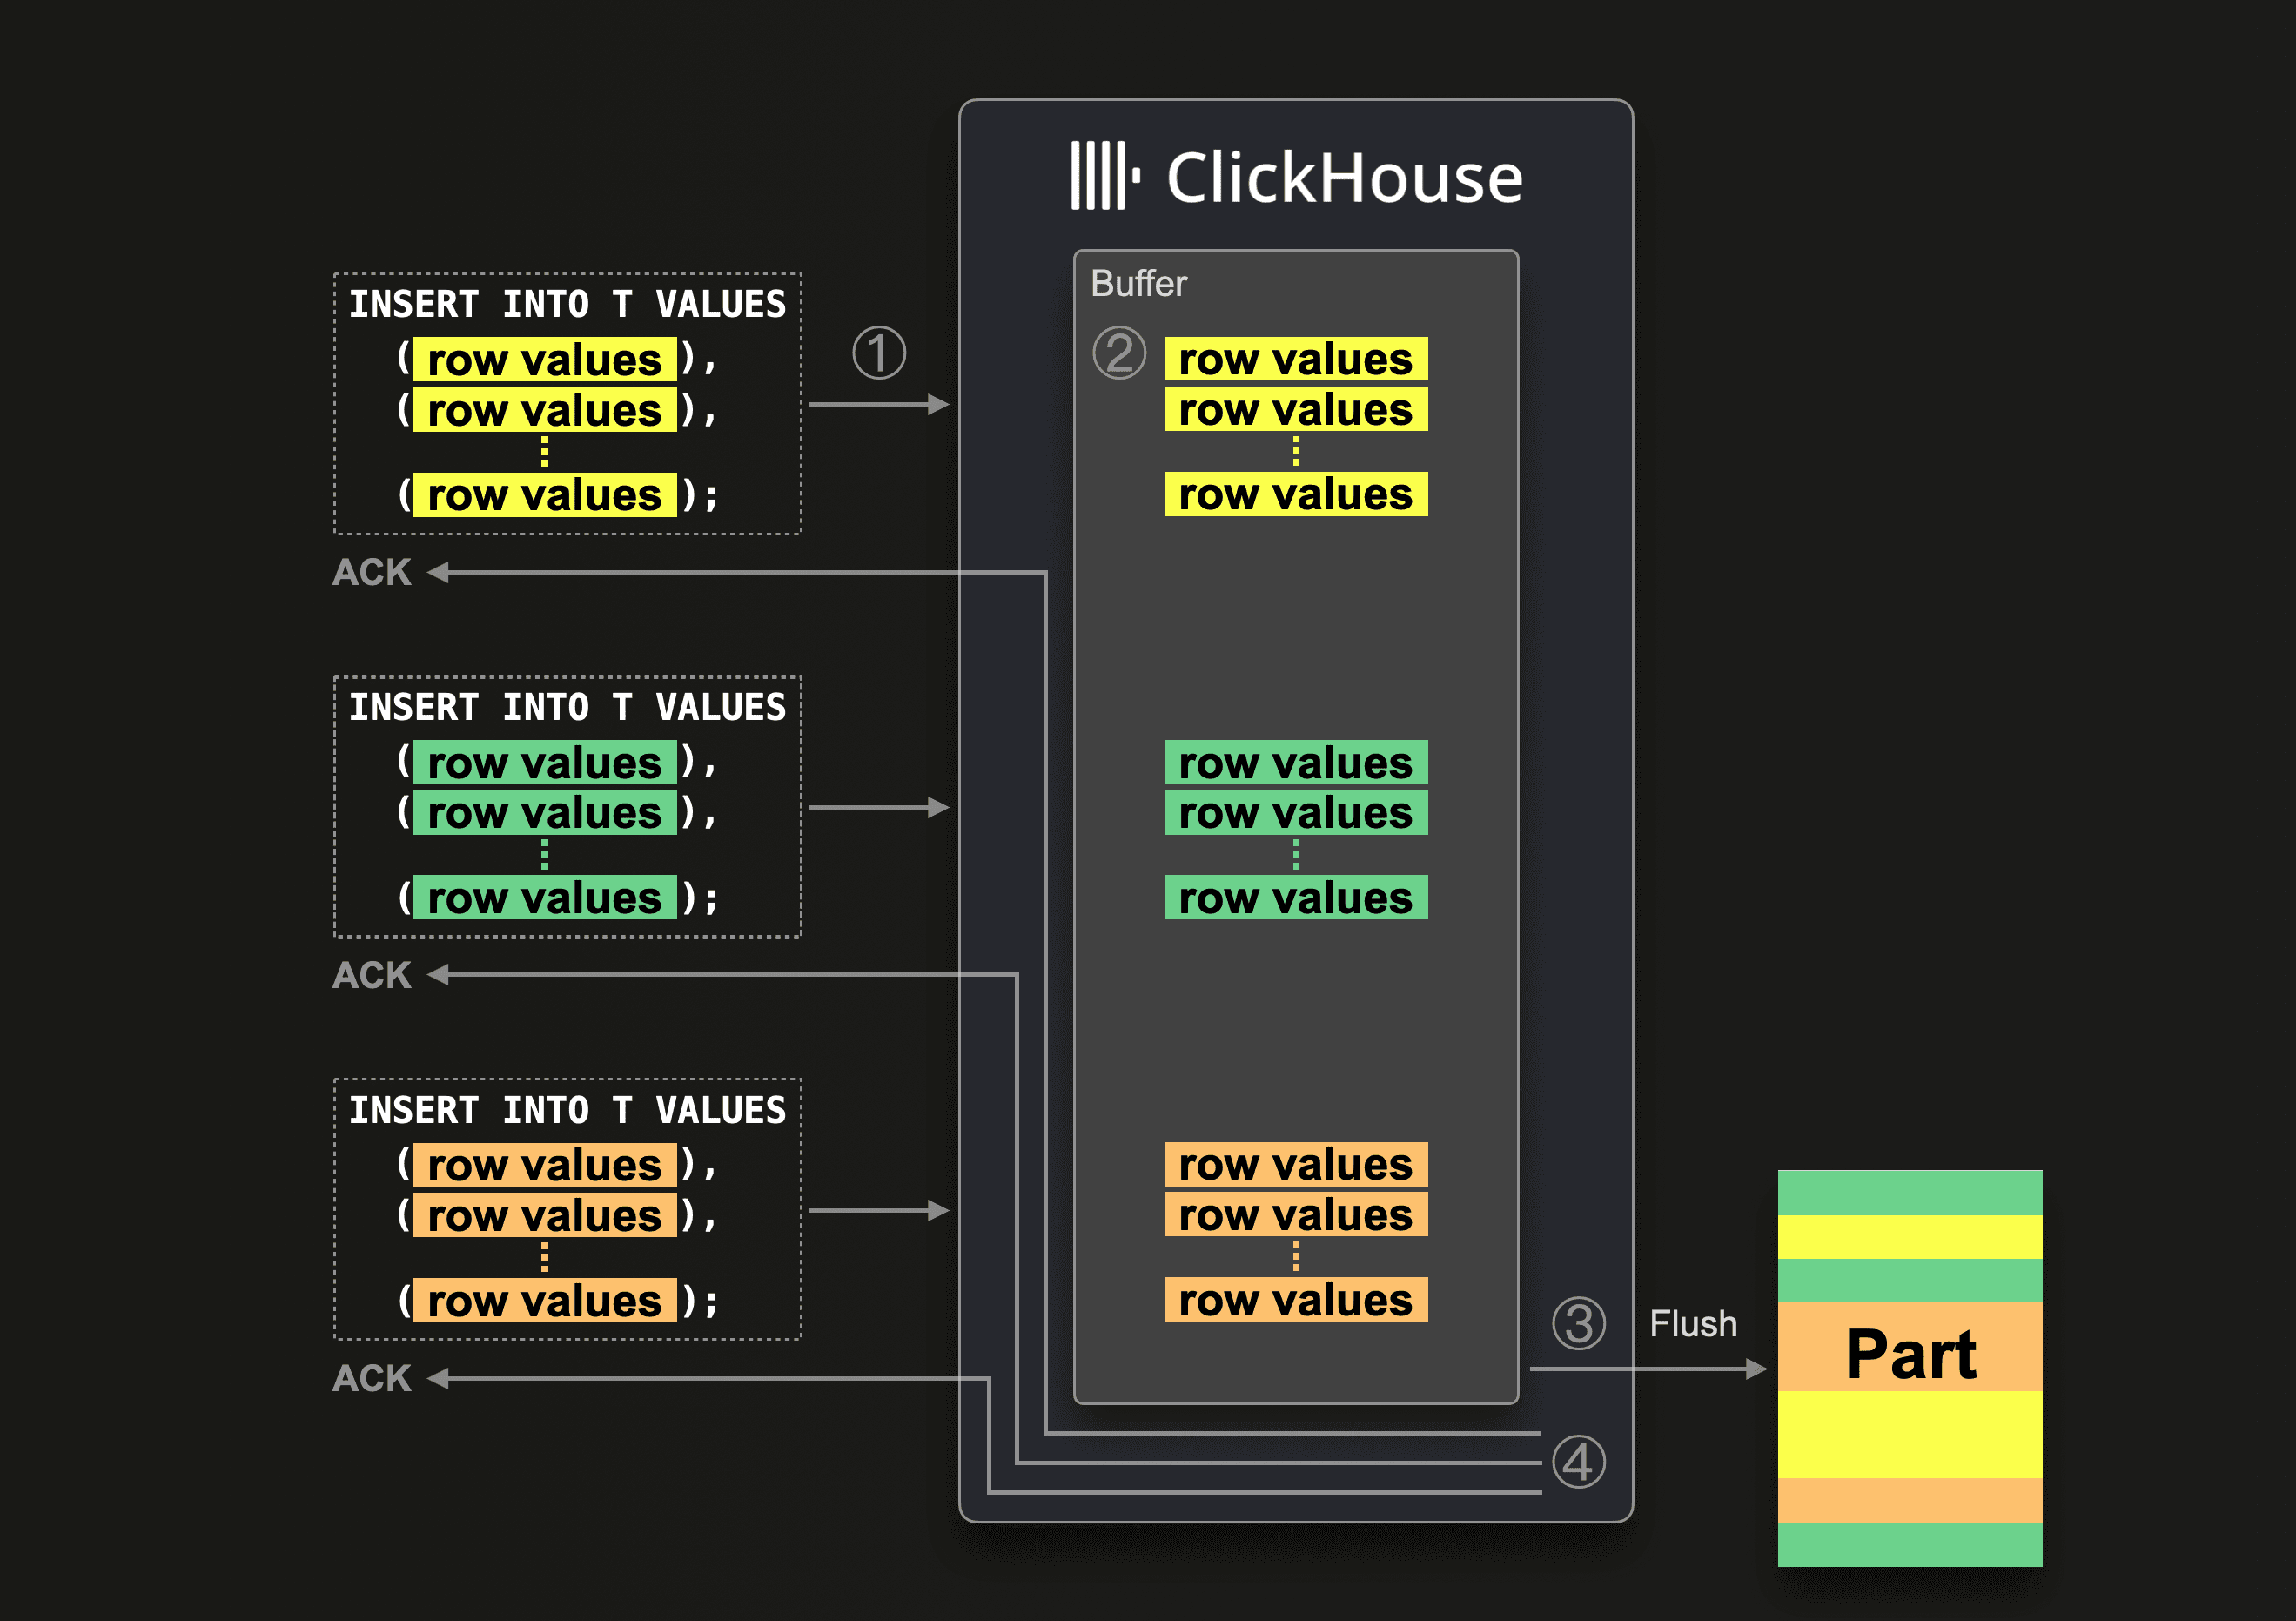
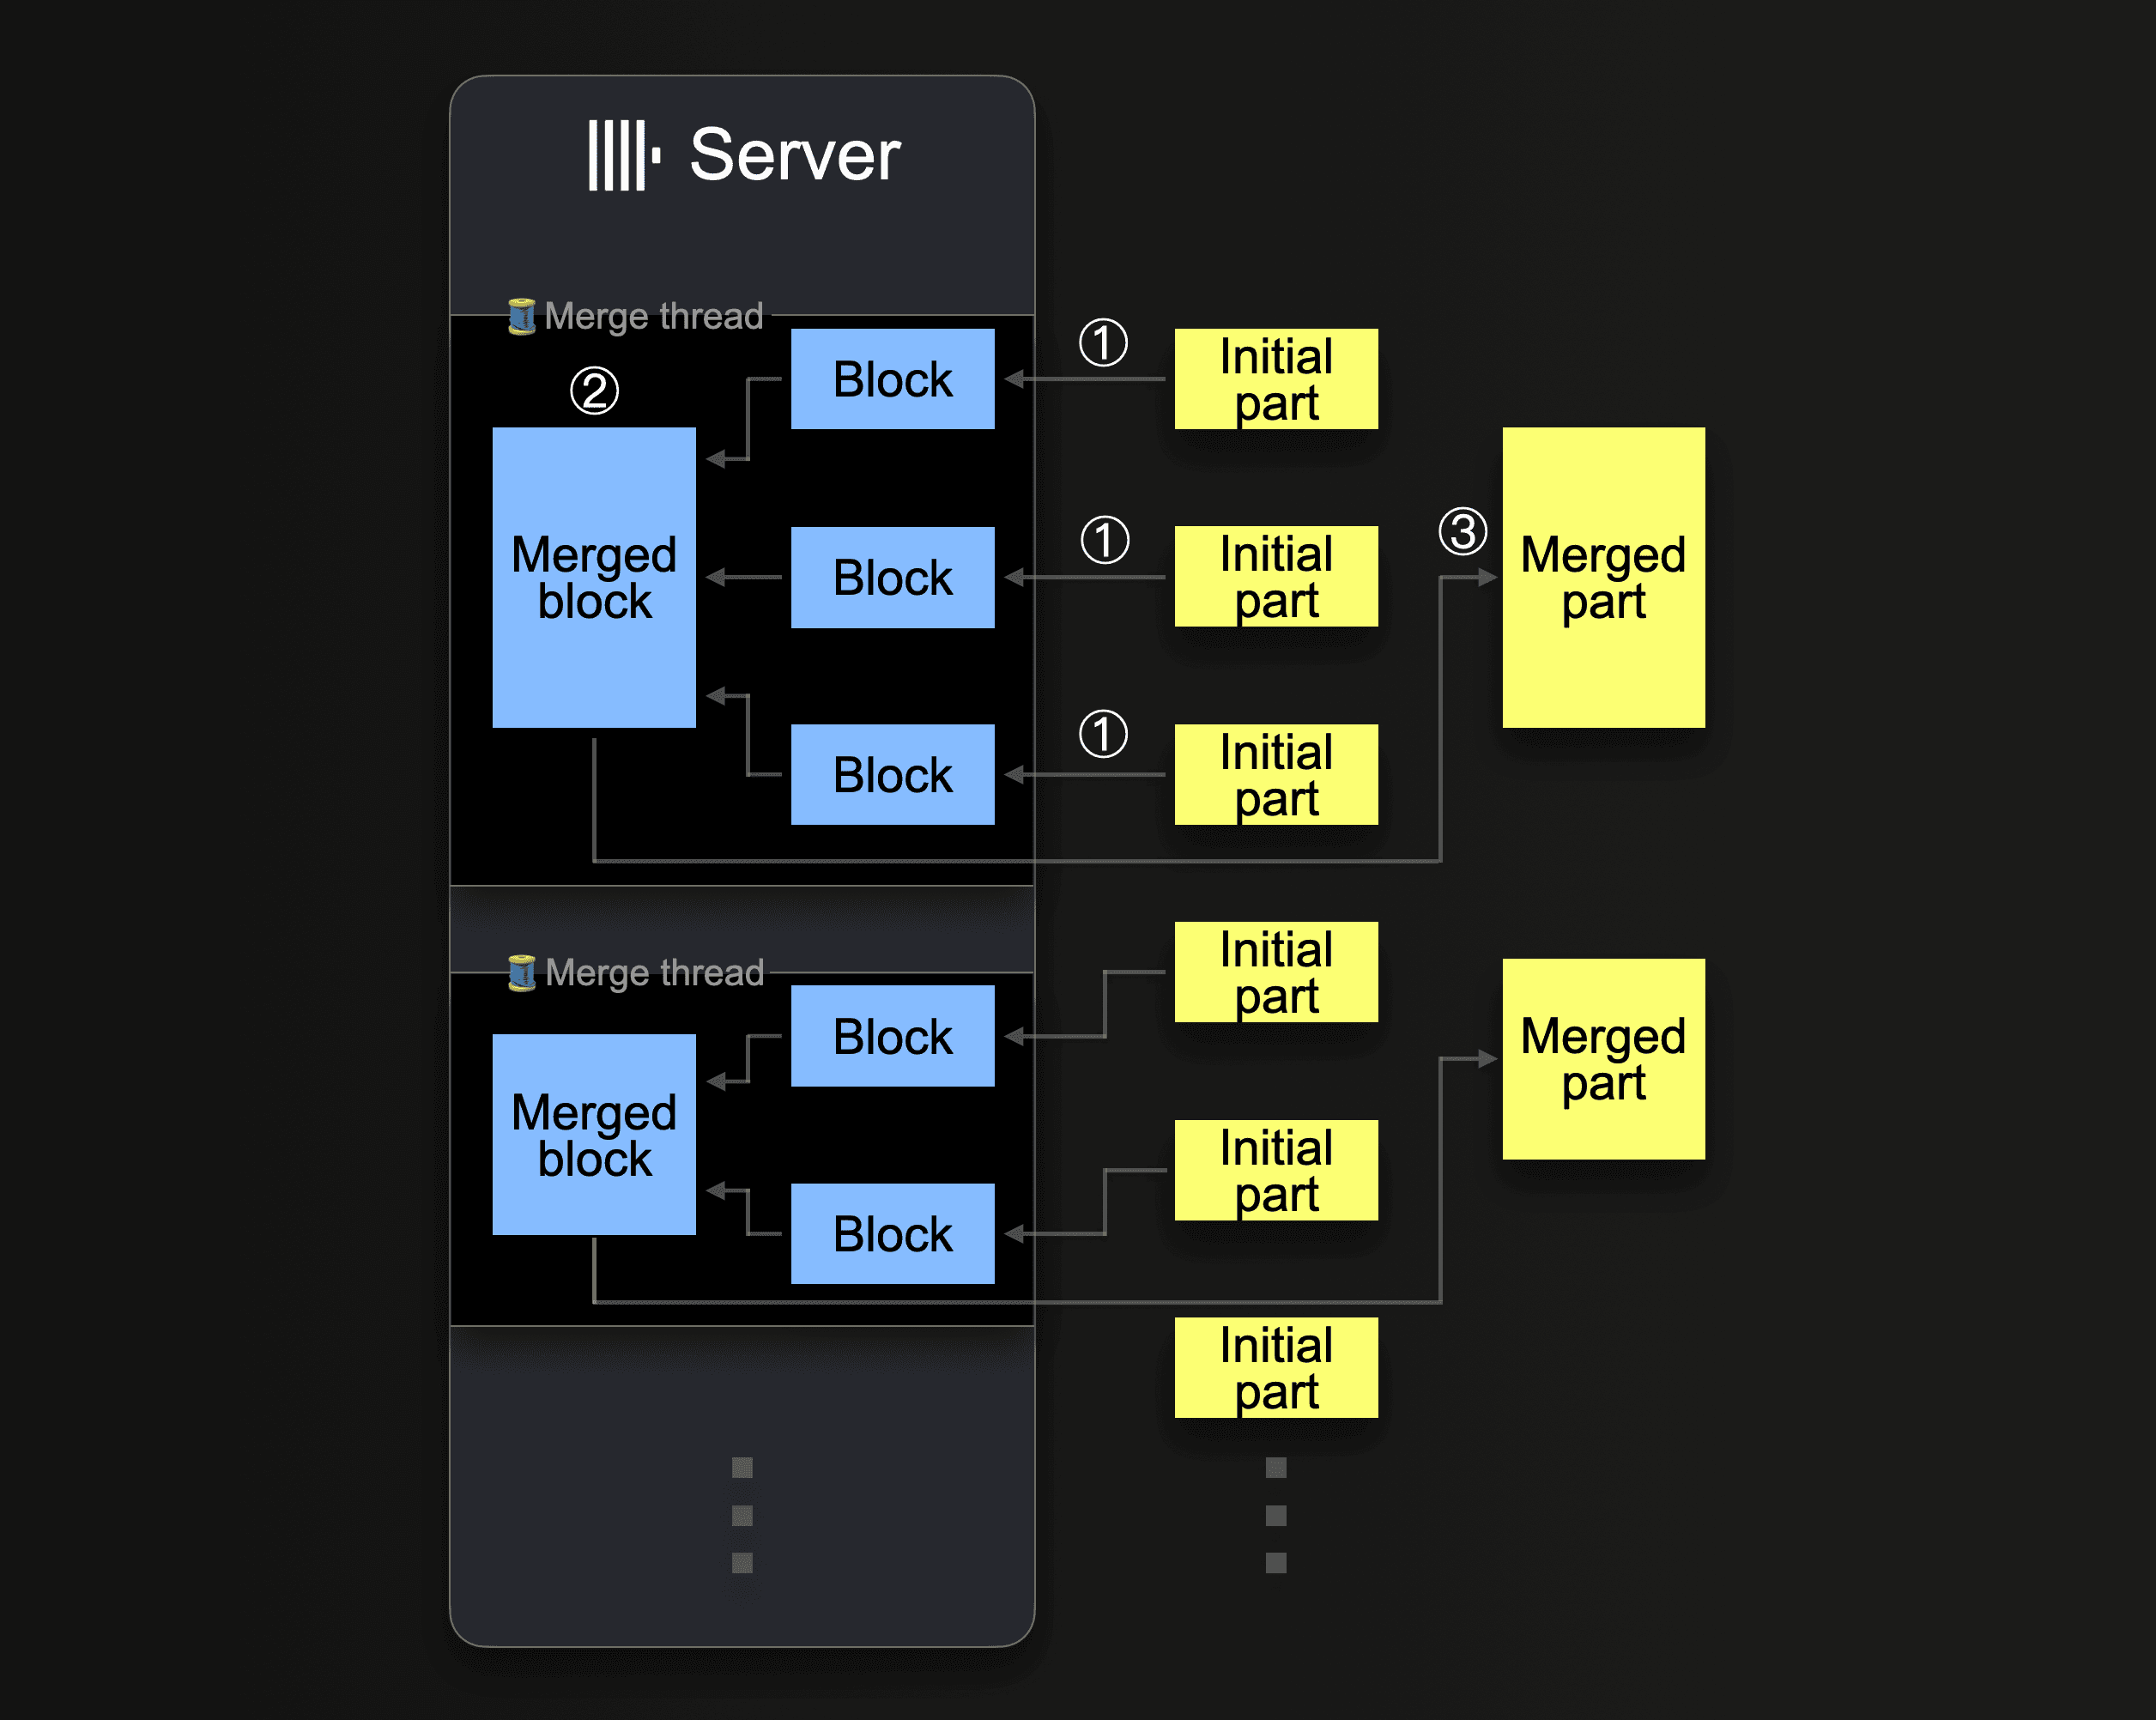
ClickHouse에서 async_insert=1을 사용하면 Memory Buffer에 요청을 모았다가 flush하여 Part 파일을 만든다. 일반적인 INSERT가 항상 비동기라는 뜻은 아니다. 생성된 Part는 이미 정렬된 열 기반 데이터이며, 이후 백그라운드 Merge가 여러 Part를 합친다. 전체 아키텍처 개괄과 비동기 INSERT 문서를 참고하자. [12], [13]
Write Buffer
Async Insert는 서버에서 요청을 모아 처리하는 방식이다. 클라이언트가 언제 성공 응답을 받는지는 wait_for_async_insert로 구분한다. 기본값인 1에서는 버퍼가 flush되어 Part에 기록될 때까지 기다리고, 0에서는 메모리 버퍼에 수용된 뒤 바로 응답한다. 따라서 비동기 INSERT와 응답을 기다리지 않는 방식은 같은 개념이 아니다. [13]
Async Insert 의 장점은 모아두었다가, 저장할 수 있음에 강력함이다. 특히, 이러한 구조는 Data Part 를 많이 만들면 만들 수록 커지는 Merge 비용과, 인덱스 문제를 적절히 피할 수 있다. 아래는 실제 Async Flush 기준이다.
| 조건 | 관련 설정 | 설명 |
|---|---|---|
| 크기 | async_insert_max_data_size | 버퍼에 일정량의 데이터가 쌓이면 |
| 시간 | async_insert_busy_timeout_ms 계열 | 설정된 대기 시간이 지나면 |
| 요청 수 | async_insert_max_query_number | 일정 수의 INSERT가 모이면 |
WAL
여기서 다루는 일반적인 MergeTree INSERT 경로에는 PostgreSQL이나 RocksDB와 같은 WAL이 없다. [12]
File Write 역시 OS Page Cache를 거칠 수 있다. wait_for_async_insert=1은 Part 기록까지 기다리지만, 그 자체로 fsync()까지 완료되었다는 뜻은 아니다. 전원 손실에 대한 영속성은 Part 파일 동기화, 저장장치와 복제 구성 등을 함께 보아야 한다. [12], [13]
Read Cache
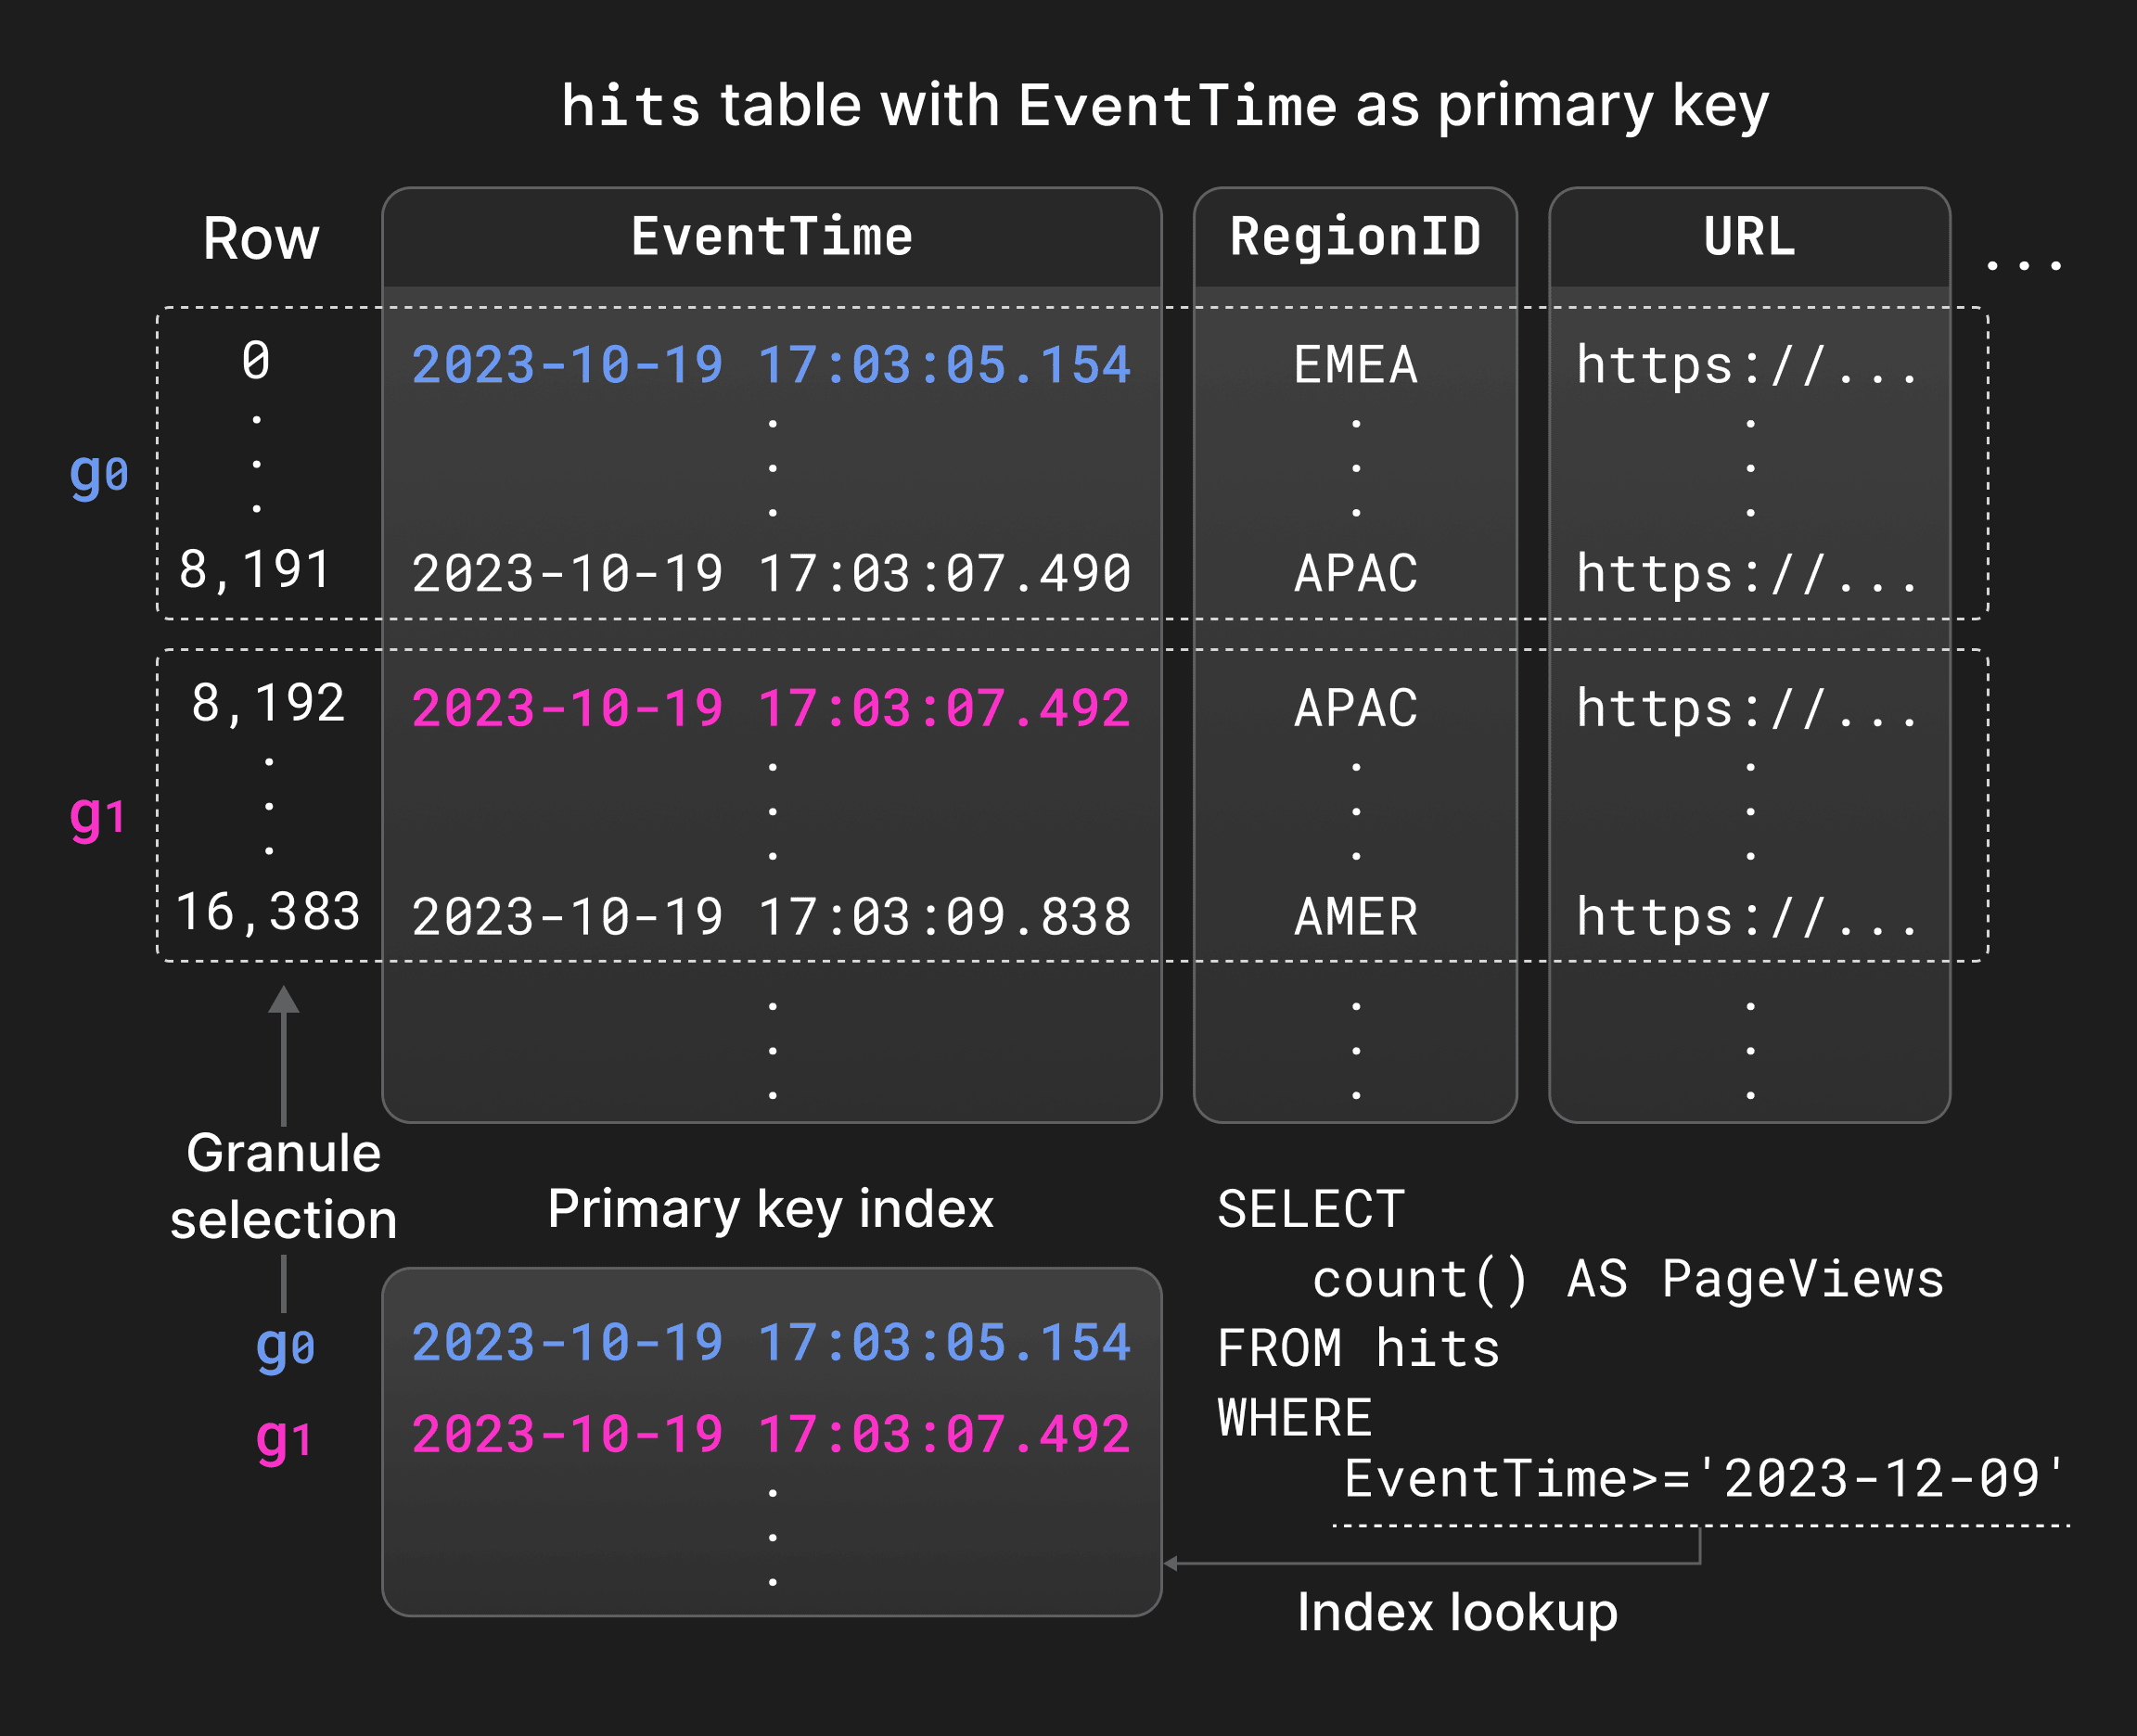
ClickHouse 는 일반적인 데이터 읽기에서 OS Caching 을 적극적으로 이용한다. 압축된 컬럼 데이터를 OS Page Cache 에서 관리하고, 인덱스 및 위치 정보 만을 별도의 메모리에 관리하는 방식을 선택한다.
위치 정보는 참고로, 실제 ClickHouse 가 B+Tree 처럼 인덱스에 따라 정확한 데이터 위치를 알 수 있는 것이 아닌, Sparse Index 이므로 해당 값이 파일에 어디있는지를 바로 알 수 없기에 위치를 캐싱하는 것이다.
결론
데이터베이스 시스템마다 상이한 메모리 사용 구조를 보면 데이터베이스 시스템이 각각 집중하는 영역에 대해서 알 수 있다. 특히 OLAP, OLTP를 가르면서 나오는 영속성 보장 기준이나, 캐싱 구조의 차이는 매우 거친 수준이다.
각 데이터베이스 시스템에 따른 메모리 사용구조와 데이터베이스 시스템이 집중하는 것이 어떤 건지를 되짚어 보는 시간이 되었으면 좋겠다.
References
[1] PostgreSQL Contributors, “Buffer Manager README,” PostgreSQL 18 source code. [Online]. Available: https://github.com/postgres/postgres/blob/REL_18_STABLE/src/backend/storage/buffer/README. Accessed: Nov. 9, 2026.
[2] The PostgreSQL Global Development Group, “WAL Configuration,” PostgreSQL 18 Documentation. [Online]. Available: https://www.postgresql.org/docs/18/wal-configuration.html. Accessed: Nov. 9, 2026.
[3] The PostgreSQL Global Development Group, “Asynchronous Commit,” PostgreSQL 18 Documentation. [Online]. Available: https://www.postgresql.org/docs/18/wal-async-commit.html. Accessed: Nov. 9, 2026.
[4] The PostgreSQL Global Development Group, “Resource Consumption,” PostgreSQL 18 Documentation. [Online]. Available: https://www.postgresql.org/docs/18/runtime-config-resource.html. Accessed: Nov. 9, 2026.
[5] Oracle, “InnoDB Startup Options and System Variables: innodb_flush_method,” MySQL 8.4 Reference Manual. [Online]. Available: https://dev.mysql.com/doc/refman/8.4/en/innodb-parameters.html#sysvar_innodb_flush_method. Accessed: Nov. 9, 2026.
[6] RocksDB Contributors, “Transactions,” RocksDB Wiki. [Online]. Available: https://github.com/meta/rocksdb/wiki/Transactions. Accessed: Nov. 9, 2026.
[7] RocksDB Contributors, “Basic Operations,” RocksDB Wiki. [Online]. Available: https://github.com/meta/rocksdb/wiki/Basic-Operations. Accessed: Nov. 9, 2026.
[8] RocksDB Contributors, “WAL Performance,” RocksDB Wiki. [Online]. Available: https://github.com/meta/rocksdb/wiki/WAL-Performance. Accessed: Nov. 9, 2026.
[9] Apache Software Foundation, “Dynamo,” Apache Cassandra Documentation. [Online]. Available: https://cassandra.apache.org/doc/stable/cassandra/architecture/dynamo. Accessed: Nov. 9, 2026.
[10] RocksDB Contributors, “Block Cache,” RocksDB Wiki. [Online]. Available: https://github.com/meta/rocksdb/wiki/Block-Cache. Accessed: Nov. 9, 2026.
[11] RocksDB Contributors, “RocksDB Change Log: 10.7.0,” RocksDB source repository. [Online]. Available: https://raw.githubusercontent.com/facebook/rocksdb/main/HISTORY.md. Accessed: Nov. 9, 2026.
[12] ClickHouse, “Architecture overview,” ClickHouse Documentation. [Online]. Available: https://clickhouse.com/docs/concepts/core-concepts/academic-overview. Accessed: Nov. 9, 2026.
[13] ClickHouse, “Asynchronous inserts (async_insert),” ClickHouse Documentation. [Online]. Available: https://clickhouse.com/docs/concepts/features/operations/insert/asyncinserts. Accessed: Nov. 9, 2026.