KVCache부터 PagedAttention까지
개요
LLM을 서빙할 때 응답이 몇 토큰까지 이어질지는 미리 알기 어렵다. 그럼 요청마다 최대 길이만큼 메모리를 잡아 두면 될까? 응답이 짧거나 아직 생성 중이라면 빈 공간이 남는데, 다른 요청은 그 공간을 쓰지 못한다. PagedAttention은 운영체제의 페이징에서 아이디어를 가져와, KV cache를 고정 크기 블록에 나눠 담고 필요한 만큼 연결한다. [1]
KV cache란
우선 일반적인 decoder-only Transformer에서 토큰 하나를 처리하는 과정을 생각해 보자. causal self-attention에서는 지금 처리하는 토큰의 Query를 자기 위치와 이전 위치의 Key에 각각 비교하고, 여기서 나온 가중치를 각 위치의 Value에 곱해 더한다. 이전 토큰은 뒤에 붙은 토큰을 볼 수 없으므로, 시퀀스 끝에 토큰을 추가해도 이미 계산해 둔 각 레이어의 K와 V는 그대로 쓸 수 있다. 이 재사용 가능성에서 KVCache가 필요하다.
실제 답변을 제공하는 LLM에서는 여기서 추가적인 처리가 필요하다. 단순히 주어진 문장에 대해 다음 단어를 예측하는 것이 아닌, 실제 프롬프트에 대한 답변을 내놓아야 하기 때문이다. 이에 대한 단계를 Prefill과 Decode로 나눈다.
- Prefill에서는 입력 프롬프트를 처리해 각 토큰의 K와 V를 레이어별로 저장하고, 첫 출력 토큰을 고른다.
- Decode에서는 직전에 고른 토큰을 입력으로 넣는다. 해당 위치의 Q, K, V를 계산하고, Q와 이전 위치에서 캐시한 K·V 및 현재 위치의 K·V로 attention을 수행해 다음 토큰을 고른다. 현재 위치의 K·V도 이후에 쓸 수 있도록 캐시에 추가한다.
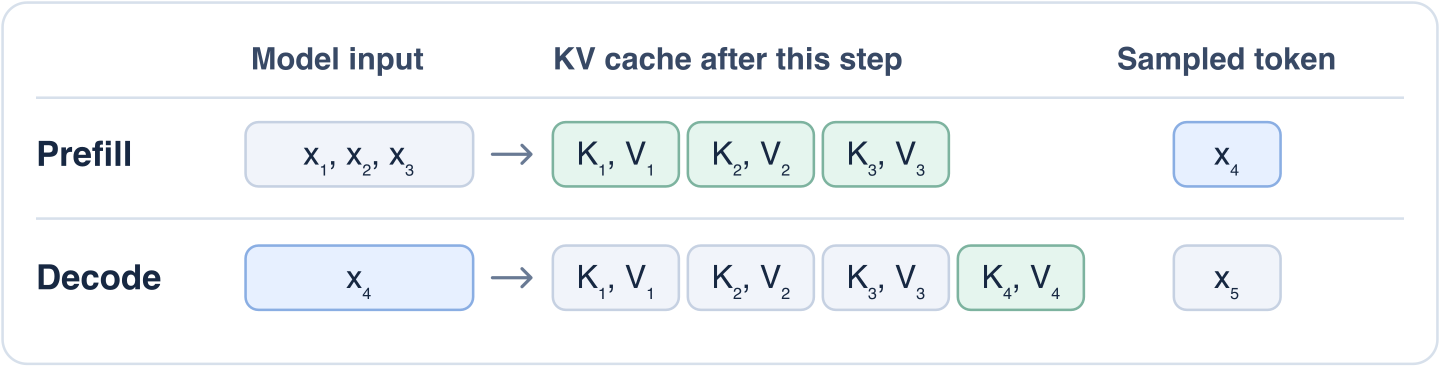
Prefill에서 고른 $x_4$가 다음 decode의 입력이 된다. 이때 KV cache에 새로 들어가는 것은 $x_4$의 K·V다.
참고로, 앞 토큰의 Q는 그 위치에서 이미 썼고, 다음 토큰은 자기 Q로 앞서 저장한 K·V를 조회한다. 전체 문맥을 보는 attention에서는 decode할 때마다 이전 위치의 K·V를 계속 읽는다. 따라서, Q에 대한 캐시는 필요하지 않다. [1]
실제 LLM을 서빙하면서 생기는 문제
시퀀스가 길어지면 그만큼 KV cache에 쌓이는 데이터도 늘어난다. 토큰 하나에 얼마나 들어갈까? 모든 attention 레이어의 형태와 자료형이 같다면 아래 식으로 계산할 수 있다.
$2$는 K와 V, $L$은 attention 레이어 수, $H_{\mathrm{KV}}$는 레이어당 KV 헤드 수, $D$는 헤드 차원, $B$는 원소당 바이트 수다. 예를 들어 레이어 32개, KV 헤드 8개, 헤드 차원 128, FP16($B=2$)이면 토큰당 128 KiB다. 입력과 출력을 합쳐 4,096개 토큰의 K·V가 쌓이면 한 시퀀스에 512 MiB가 든다. 물론, 이러한 데이터 용량을 줄이는 기법 또한, 많다. GQA, MLA 등으로 KVCache 자체를 줄이거나 저장용량의 양자화, 메모리 오프로딩 기법 등이 존재할 수 있다. 하지만, 당장은 PagedAttention 에 집중해보자.
요청 하나에 최대 2,048개 토큰이 들어갈 연속 공간을 잡아 뒀다고 해보자. 200개 토큰을 처리한 시점에는 200칸만 쓰고 나머지 1,848칸은 예약해 둔다. 여기서 요청이 일찍 끝나면 끝까지 쓰이지 않는 칸이 남는데, 이게 실제 서빙 시에 나타나는 내부 단편화일 것이다.
또한, 여러 요청에 크기가 다른 연속 공간을 할당하고 반환하다 보면, 빈 공간 자체가 여러 곳으로 흩어질 수도 있다. 빈 곳을 다 합치면 충분한데도 다음 요청에 내줄 만한 연속 구간이 없는 경우가 외부 단편화다.
실제로 2023년 PagedAttention 논문에서는 비교 대상 시스템이 KV cache에 할당한 메모리 중 평균 **20.4~38.2%**만 실제 토큰의 K·V를 담는 데 썼다고 한다. 나머지에는 미래 토큰을 위해 예약한 공간과 내부·외부 단편화로 생긴 빈 공간이 포함된다. [1, Fig. 2]
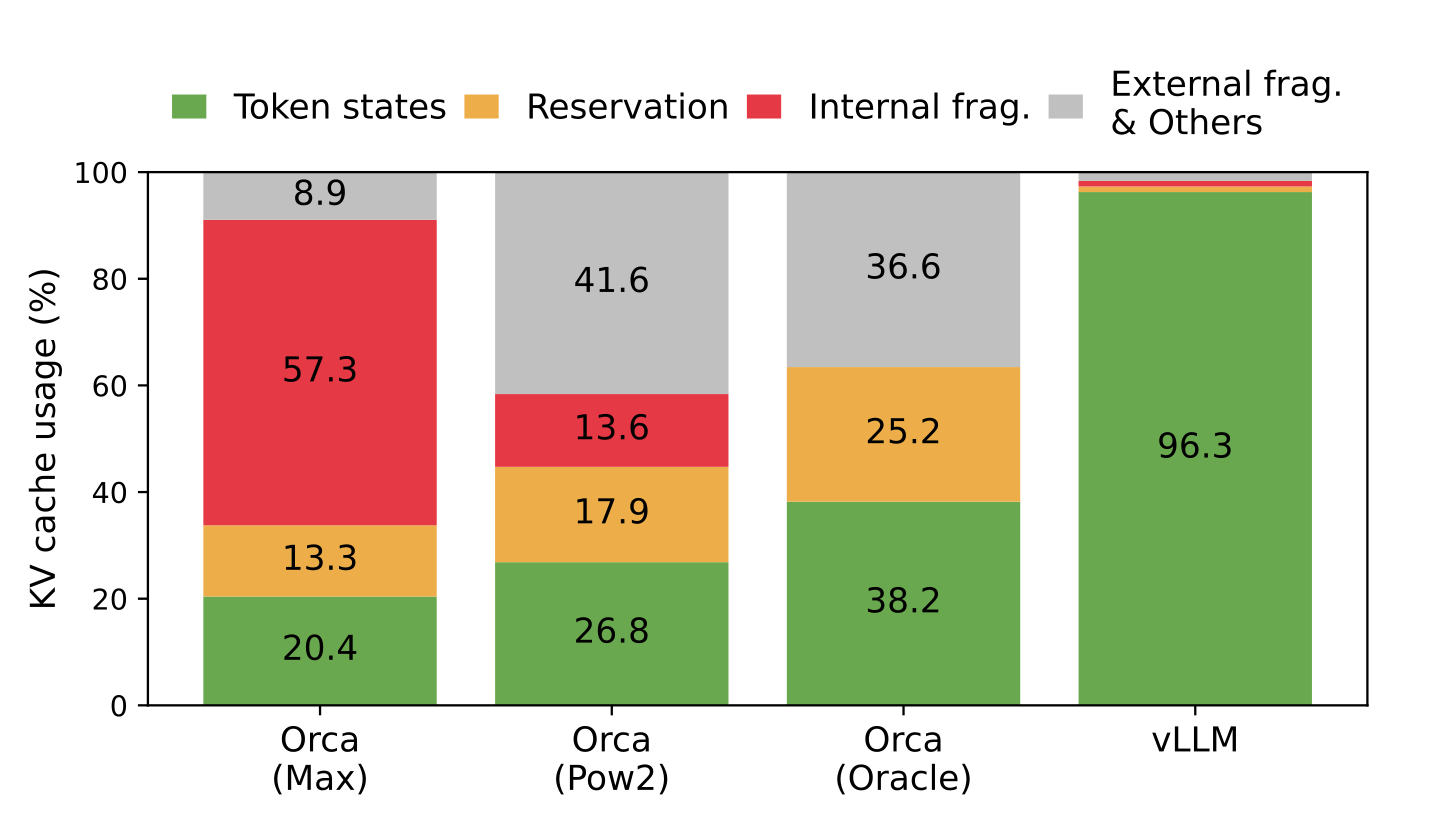
초록색이 실제 토큰의 K·V가 차지한 비율이다. 같은 실험에서 vLLM은 KV cache 공간의 96.3%를 실제 토큰의 K·V에 썼다. [1, Fig. 2]
PagedAttention
PagedAttention 역시 결국에는 GPU 메모리를 같은 크기의 물리 블록으로 나눠 풀로 관리한다. 각 시퀀스의 블록 테이블에는 토큰 순서대로 논리 블록을 두고, 각각이 어느 물리 블록을 쓰는지 적어 둔다.
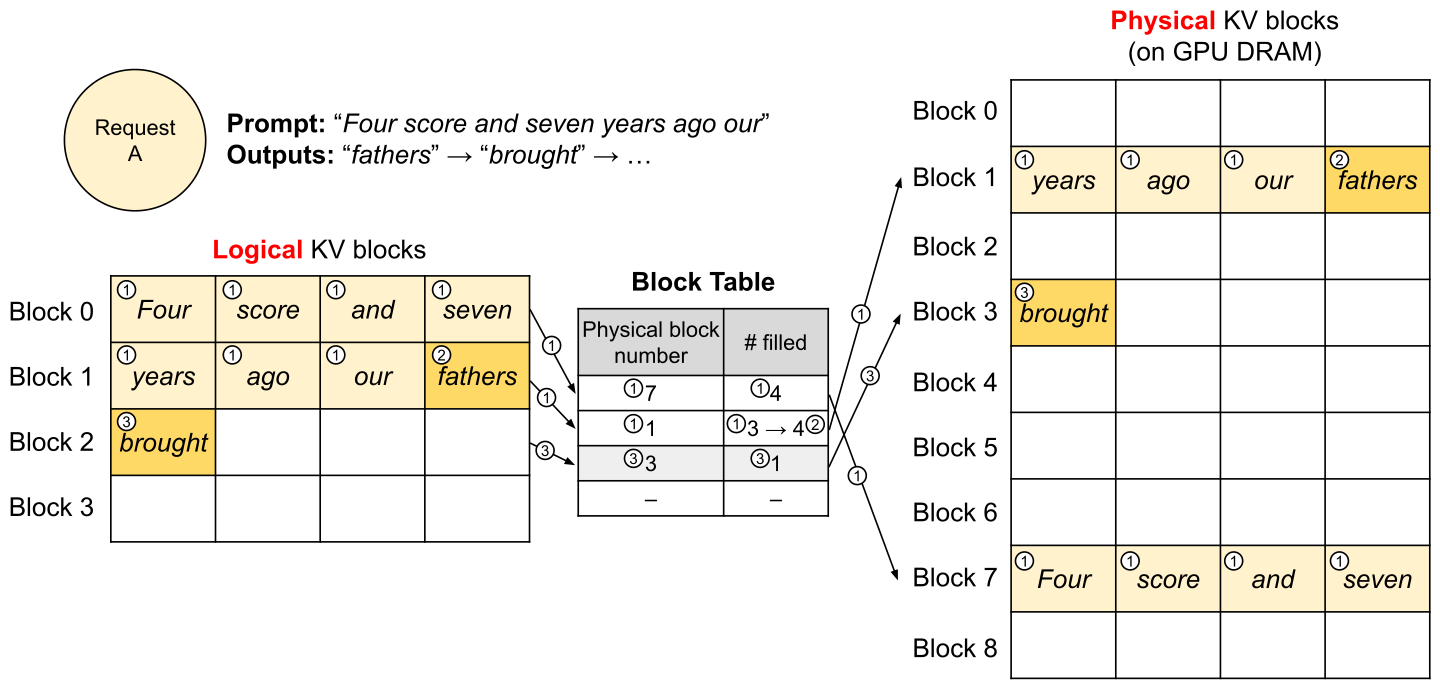
논문 그림에서는 물리 블록 1의 마지막 칸을 채우고(②), 다음 토큰을 처리할 때 물리 블록 3을 새로 할당한다(③). 아래 예시에서도 블록 번호를 바꿔 같은 과정을 따라가 보자. [1, Fig. 6]
블록 하나에 토큰 4개의 K·V가 들어간다고 하자. 토큰 6개를 처리한 시퀀스는 다음처럼 저장할 수 있다.
| 논리 블록 | 토큰 위치 | 물리 블록 | 사용 중인 칸 |
|---|---|---|---|
| 0 | 1~4 | 7 | 4/4 |
| 1 | 5~8 | 2 | 2/4 |
7·8번째 위치의 K·V는 물리 블록 2의 남은 두 칸에 쓴다. 9번째 위치를 처리할 때는 빈 물리 블록을 하나 골라 논리 블록 2에 매핑한다. 예를 들어 물리 블록 11을 받으면 블록 테이블은 [7, 2, 11]이 된다. Attention 커널은 이 테이블을 따라 물리 블록에서 유효한 K·V를 읽고, 현재 위치까지의 토큰을 대상으로 attention을 계산한다. [1, §4.1–4.3]
마지막 블록이 찰 때마다 빈 블록 하나를 더 가져오면 된다. 요청이 끝날 때 다른 시퀀스가 쓰지 않는 블록은 풀로 돌려준다. 모든 블록의 크기가 같으니 풀 어디에 있든 빈 블록을 가져다 쓸 수 있다. 블록 안에 빈칸이 남는 곳도 시퀀스의 마지막 블록뿐이다. 그만큼 같은 GPU 메모리에서 한 배치에 더 많은 요청을 담을 수 있다. [1, §4.2–4.3]
그러면 블록을 작게 잡을수록 좋을까? 마지막 블록에 남는 빈자리는 줄겠지만 GPU가 블록을 읽을 때 활용할 수 있는 병렬성이 떨어질 수도 있다. [1, §7.2]
더 나아가서
같은 프롬프트에서 답변 후보를 여러 개 만들면 앞부분은 서로 같다. 이때 프롬프트의 물리 블록을 후보들이 같이 쓸 수 있다. 그러다 한 후보가 마지막 공유 블록의 빈칸에 새 토큰을 써야 하면, 그 블록만 복사하고 해당 후보의 블록 테이블을 바꿔 준다. COW(copy-on-write)와 동일한 방식이다. [1, §4.4]
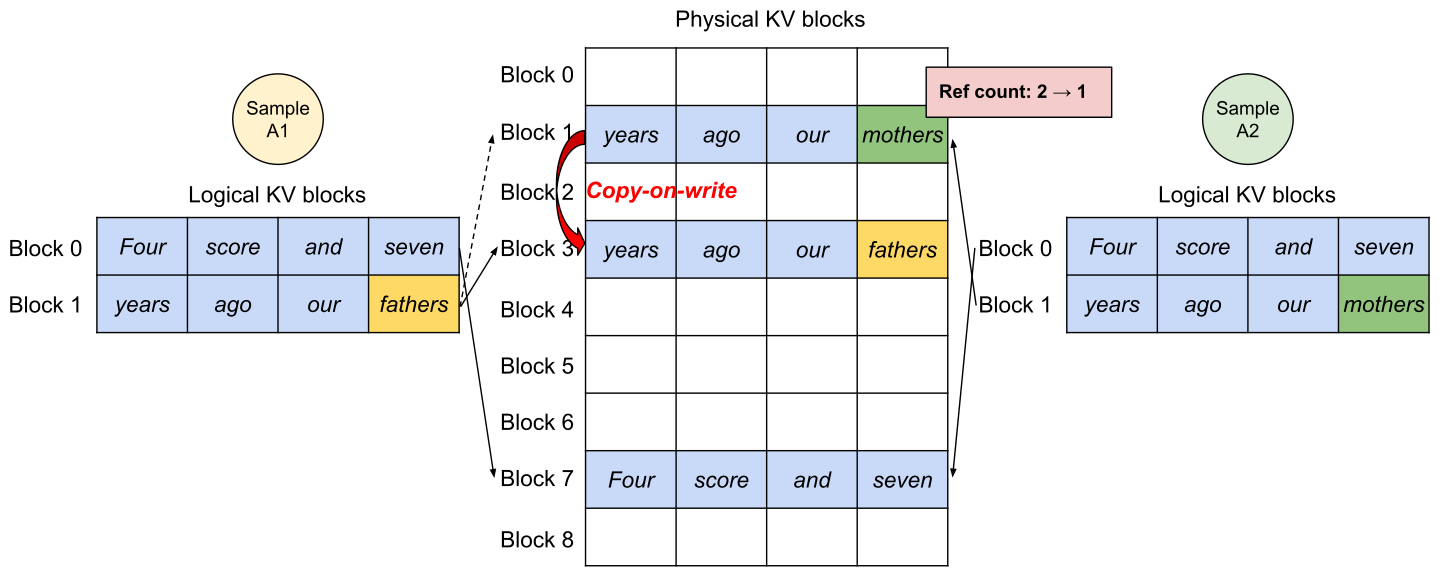
두 후보는 물리 블록 7을 계속 공유한다. A1은 새 토큰을 쓰기 전에 마지막 공유 블록을 1에서 3으로 복사하고, A2는 기존 블록 1을 쓴다. [1, Fig. 8]
특히, GPT, Claude와 같은 시스템은 특히, 앞에서 미리 붙여둘 시스템 프롬프트는 동일하게 사용될 가능성이 매우 높다. 서로 다른 요청이어도 앞부분 토큰은 같을 수 있다. vLLM에서는 Automatic Prefix Caching으로 공통 접두사의 KV cache 블록을 다시 쓴다. 그러면 prefill에서 이미 계산한 부분을 건너뛰고, 새 답변 토큰을 만드는 decode는 이어서 수행한다. [2]
References
[1] W. Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” in Proc. 29th ACM Symp. Operating Systems Principles (SOSP ’23), 2023, doi: 10.1145/3600006.3613165. [Online]. Available: https://arxiv.org/html/2309.06180. Accessed: Nov. 19, 2026.
[2] vLLM, “Automatic Prefix Caching,” vLLM Documentation. [Online]. Available: https://docs.vllm.ai/en/stable/features/automatic_prefix_caching/. Accessed: Nov. 19, 2026.
Fig. 2, 6, 8은 W. Kwon et al.의 논문 [1]에 실린 그림을 PNG로 변환해 실었다. CC BY 4.0.