주소 변환과 Huge Page
메모리의 사용 방식과 메모리의 실제 Address Translation 에 대해서 설명한다. 이에 대해서는 크게 정리하지 않겠다. MMU라는 하드웨어 구조 장치에서 일어나는 과정이며 이를 이용하는 소프트웨어 아키텍처 등을 알아보자.
기본적인 주소 변환 과정
기본적인 translation 과정은 하드웨어 아키텍처와 OS가 함께 협업하며 작업한다. 현대 CPU 아키텍처에서는 MMU의 구성요소로는 TLB(Translation Lookaside Buffer)가 존재한다. TLB는 L1, L2에 존재하며 계층별 캐싱 구조로 이루어져있다. 만약 두 단계에서 모두 Cache miss가 난다면, Page Walker 계층에서 마지막 캐싱 여부를 판단하고, Page Table에서 데이터를 가져온다.
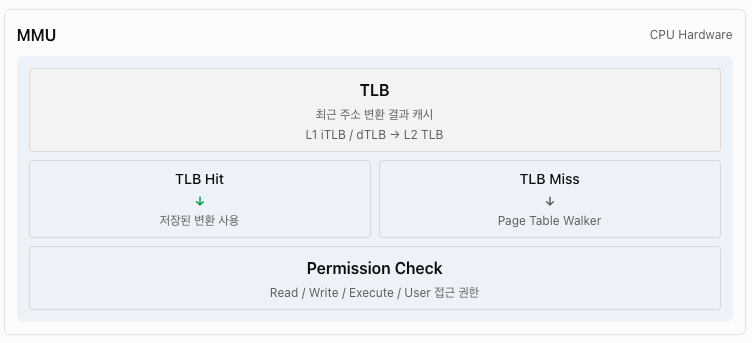
Page Table 의 가상 주소를 찾기 위한 작업은 결국 DRAM을 훑는 작업이고 이에 대한 병목이다. L1 TLB, L2 TLB, Page Walker 까지 내려가는 계층 개념에서 또 다시, 캐싱된 값을 찾고 그 값이 없다면 DRAM에 접근한다.
이 과정은 익히 알 수 있듯이, 수십 사이클에서 수백 사이클까지 걸릴 수 있지만 아키텍처마다 상이하다.
Huge Page
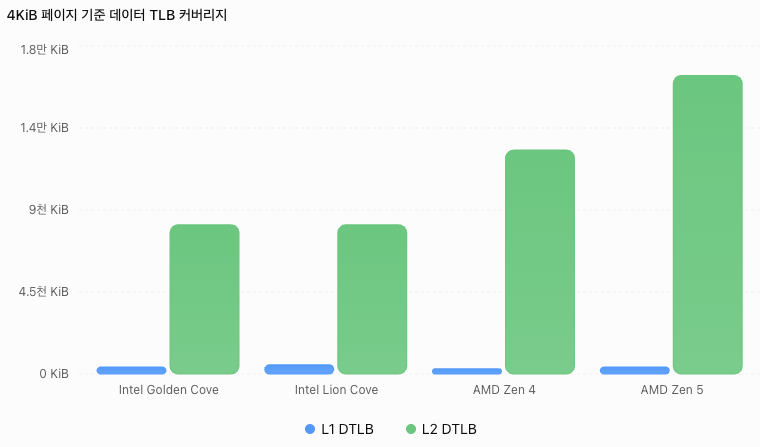
여기서 중요한 건, 결국 수백만 개의 페이지를 사용하는 워크로드의 경우는 이러한 TLB의 사용에도 이점을 가지기 위해서 여러 방식을 적용해야 한다는 의미이다. 단적인 예로, 8GiB를 이용하는 경우 4KiB 페이지의 경우는 2,097,152개를, 2MiB의 Huge Page의 경우는 4096개로, 더더욱 TLB의 저장하는 값에 대한 교체가 자주 일어나게 될 것이다. [1] 보통, TLB는 몇 개의 페이지 매핑을 저장할 수 있는지에 대한 “개수"로 표현하기에 L1은 수십~수백, L2는 수천 개의 엔트리를 저장할 수 있다.
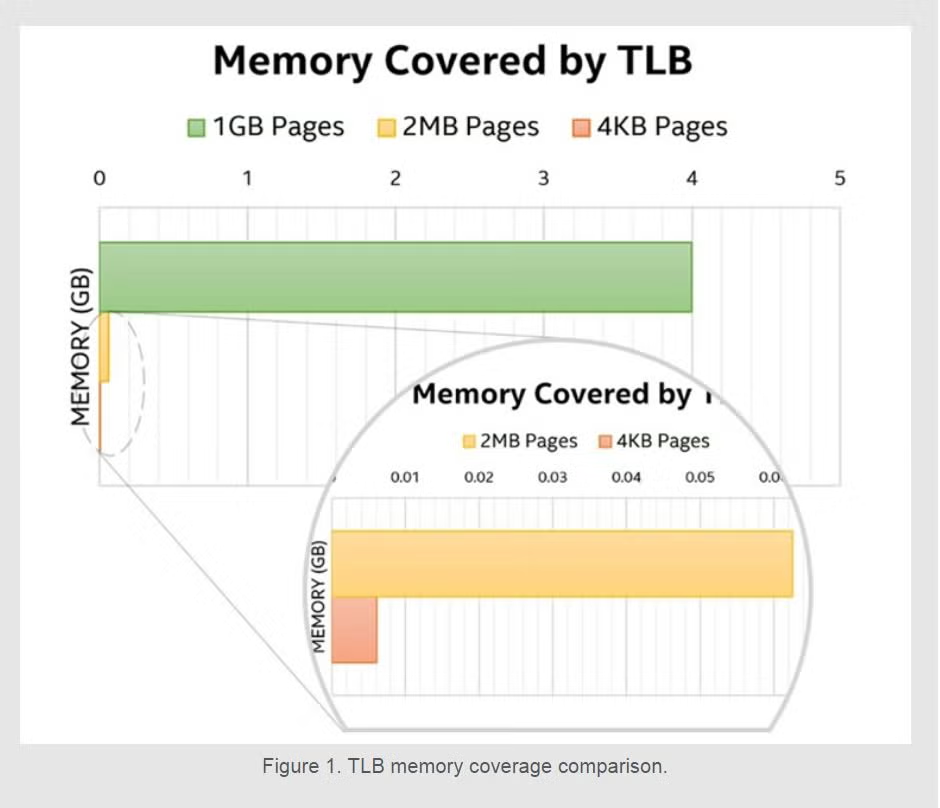
다만, Huge Page를 통해 생기는 Fragmentation(internal, external)에 대해서 정리하는 것 역시 추가적인 코스트일 수 있기에 이러한 Huge Page 사용은 실제 소프트웨어 시스템에 따라 상이할 수 있다.
psql
psql은 앞서 설명한 Huge Page 설정을 제공한다. 이를 통해 실제 벤치마크 결과에서는 10~13% 정도의 성능 개선으로 연결되었다는 결과 또한 존재한다. [2] 특히, 높은 CPU 사용률을 보이는 Random Access가 주로있는 워크로드의 경우는 더욱 실제 효과를 보기 좋다. 달리 말하자면 특정 워크로드에서 더욱 좋은 성능을 내는 거지 항상 Huge Page를 쓰는 것이 장점이 되진 않는다.
DPDK(Data Plane Development Kit)
DPDK는 고성능 네트워크 패킷처리를 위한 Linux Foundation 오픈소스 프로젝트로, NIC에서 받아온 데이터를 CPU, 유저 어플리케이션까지 운반하는 경로를 최적화한다. 아래는 일반적인 네트워크 패킷 처리 과정이다.
              Network
                 │
                 ▼
          NIC (Network Card)
                 │
           DMA to RAM
                 │
                 ▼
       Linux Kernel Driver
                 │
                 ▼
         Linux TCP/IP Stack
                 │
                 ▼
         Socket / recv()
                 │
                 ▼
         User Application
그와 다르게 DPDK는 커널 네트워크 스택을 우회한다. 물론, 우리는 이러한 커널 스택을 우회하는 다양한 최적화 기법을 안다.
Mempool
여기서 중요한 건, 그래서 DPDK에서 어떻게 Huge Page를 어떻게 사용하는가이다. 실제로 주요 컴포넌트 Mempool은 실제 Huge Page로 구성된 메모리 풀을 통해 네트워크 패킷들을 저장하고(rte_mbuf), 이를 CPU에서 가져올 수 있도록 한다. 수많은 rte_mbuf에 접근하기 위해 가상 주소를 변환하는 게 아니라, Huge Page를 두어서, TLB Hit율을 높이는 방식이다. 이는 실제 메모리 설계의 핵심 요소이다. [1]
반대 케이스: Redis의 Transparent Huge Pages(THP) 비활성화 권장
자 그렇다면, 실제로 Huge Page가 항상 좋다는 결론에 도달할 수도 있겠지만, 항상 그런 것만은 아니다. THP는 Linux가 제공하는 HugeTLB(미리, 정적 페이지 개수를 할당)과 반대로 동적으로 기존에 있던 페이지를 병합/분할/회수 하도록 하는 메모리 관리 메커니즘이다.
다만, Redis가 이 옵션을 끄는 것을 권장하는 가장 중요한 이유는 Redis가 실제로 fork() 및 COW(Copy-On-Write)를 사용하는 방식에 있다. Redis가 BGSAVE 요청을 통해, RDB Snapshot 등을 만드는 과정에서 자식과 부모가 같이 공유하는 메모리를 만들지만, write 가 일어날 때마다 COW를 통해 새 페이지를 만들고, 기존 페이지는 child만 사용하도록한다. 이러한 과정에서 THP에 이점을 잃고, 메모리 매핑을 변경하는 등의 추가적인 병목이 생길 수 있는 상황이다.
매우 바쁜 워크로드에서는 특정 커맨드가 수백, 수천 개의 페이지에 영향을 미칠 경우, 메모리와 CPU 압박이 매우 커질 수 있다. [3]
References
[1] https://www.dpdk.org/memory-in-dpdk-part-1-general-concepts/ [2] https://www.enterprisedb.com/blog/improving-postgresql-performance-without-making-changes-postgresql [3] https://redis.io/docs/latest/operate/oss_and_stack/management/optimization/latency/#latency-induced-by-transparent-huge-pages