SRAM의 구조와 용량 확장의 한계
개요
여태 DRAM Access는 지속적으로 CPU cycle에서 보자면 높은 latency로 인해 OS에서는 지양해야할 패턴으로 설명했었다. 반대로 SRAM은 L1, L2, L3 정도의 계층형으로 데이터 용량을 어느정도 커버할 수 있었지만, Cache Hit ratio 등 다양한 고민거리와 OS 단에서의 문제를 더욱 만드는 구조였다.
그러면 반대로 SRAM의 용량을 더 늘릴 수는 없을까? 실제 책에서도 이러한 SRAM 구조는 확장 가능하지 않은 전자공학적 문제가 있다고 설명한다. 간만에 컴구도 훑을 겸 SRAM이 왜 확장 불가능한지 이야기해보자.
SRAM의 구조
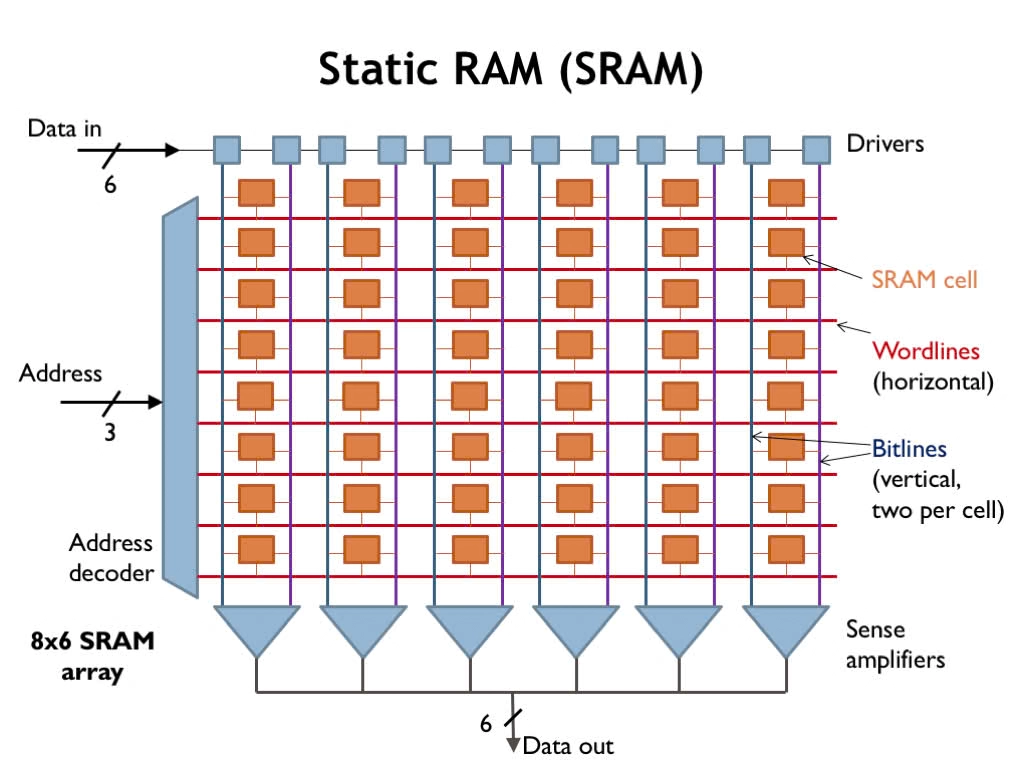
우선 SRAM의 구조를 알아야, 실제 SRAM이 확장이 왜 어렵고 어떠한 trade-off가 있을지 알 수 있다.
| 구성요소 | 역할 |
|---|---|
| SRAM Cell | 실제 1bit를 저장하는 회로 |
| Wordline (WL) | 어떤 행의 셀을 읽을지 선택 |
| Bitline (BL/BLB) | 셀과 데이터를 주고받는 전기적 배선 |
| Sense Amplifier | 미세한 전압 차이를 0 또는 1로 판별 |
SRAM에는 크게 4가지 구성요소가 존재한다. 위 예시는 간소화된 8x6 배열의 SRAM을 나타낸다. 각 Cell은 Bitline 이라고 하는 vertical 전기 배선으로 되어있으며, 두 개가 하나의 셀을 맡는다.
실제로, 우리가 특정 라인(row)에 저장되어있는 값을 읽는다고 했을 때, N번째 해당하는 wordline에 전압을 가하여, 해당 라인에 있는 SRAM Cell이 각각 자신이 연결된 Bitline을 통해 데이터를 읽을 수 있는 상태가 된다. 다만, 둘 사이에서 전압이 조금씩 변하기에, 이 변화를 감지할 수 있도록, Sense Amplifier가 필요하다.
SRAM Cell의 저장 구조
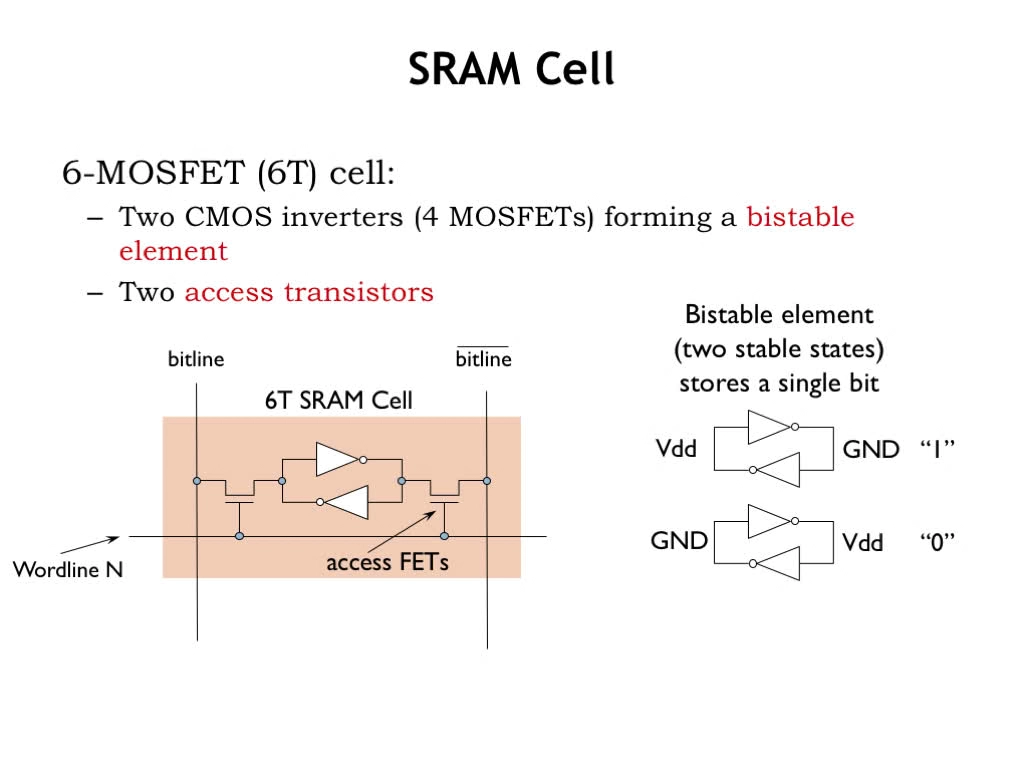
일반적인 구조인 6T SRAM Cell은 여섯 개의 트랜지스터로 이루어져있고, 각각 4개는 두 개의 CMOS Inverter를 만들어 0또는 1 상태를 유지한다. 남은 2개는 **Wordline이 활성화될 때, 내부 셀을 연결(Access Transistor)**하는 역할이다.
SRAM Cell은 Bitline을 직접 구동해서 전압을 변화시켜야 해. 여기서 Bitline은 정전용량(Capacitance)을 가지고 있고, 이를 이용해 아래와 같은 수식이 유도가 가능하다.
- Bitline의 정전용량: $C_{BL}$
- 셀이 Bitline에서 끌어내리는 전류: $I_{read}$
- Sense Amplifier가 판별하는 데 필요한 전압 차이: $\Delta V$
충전된 전하량의 관계식 $Q=CV$와 전류의 정의 $I=dQ/dt$를 이용하면 시간과, Bitline의 정전용량 및 전압차이 그리고 전류와의 상관 관계를 구할 수 있다.
${t_{read}\approx\frac{C_{BL}\Delta V}{I_{read}}}$
이러한 식 유도를 통해 실제로 CPU 설계를 할 때는 생기는 trade-off는 트랜지스터를 작게 설계, 크게 설계, Bitline을 짧게 설계하는 등의 여러 파생된 설계 문제를 만날 수 있다.
- 트랜지스터를 작게 설계하면, 전류 구동 능력이 감소하여 읽기 지연이 증가한다. 다만, 높은 집적도와 면적 감소 효과를 볼 것이다.
- 트랜지스터를 반대로 크게 한다면, 높은 구동 전류로 인해 빠른 Bitline 방전이 가능하다. 하지만, 그만큼 셀 면적 증가 및 기생 정전용량이 증가하여 더 많은 전류량이 필요하다.
- Bitline을 짧게 설계한다면, 정전 용량 감소 및 빠른 읽기를 얻겠지만, 배열을 분할하고 주변 회로 설계가 추가되는 문제가 있다.
많은 Cell을 연결할 경우
Bitline에 많은 Cell을 연결할 경우, 읽기 속도는 저하된다. 왜 그럴까? 직관적으로는 선택되지 않은 Row들은 영향을 주지 않을 것 같다. 다만, Access Trasistor가 실제로는 꺼져있어도, Bitline에 연결된 트랜지스터는 단자의 기생 정전용량(Parasitic Capacitance)에 영향을 준다.
$C_{BL}\approx C_{fixed}+N\cdot C_{per\ cell}$ 는 실제 총 정전용량의 근사치이다. 행수가 많아지면, 하나의 작은 SRAM Cell이 더 큰 정전용량을 가진 Bitline을 방전해야한다.
- $N$: 하나의 Bitline에 연결된 셀 수, 즉 행 수
- $C_{per\ cell}$: 셀 하나당 추가되는 기생 정전용량과 배선 기여분
- $C_{fixed}$: 주변 회로와 고정 부하에 따른 정전용량
즉, 행수를 여러 개 늘림으로 인해서, Bitline의 전기적 부하가 크게 증가하고, SRAM Cell이 똑같은 전압 차이를 만들기 위해 더 “오래” 작동해야한다는 의미다.
읽기 vs 쓰기
실제로는 깊게 다루기 어렵지만, Read Stability vs Writeability Trade-off도 존재한다. 보통, 6T SRAM은 아래와 같은 트랜지스터로 종류를 나눌 수 있는데,
| 종류 | 역할 |
|---|---|
| Pull-down NMOS (PD) | 셀 내부의 0 상태 유지 |
| Pull-up PMOS (PU) | 셀 내부의 1 상태 유지 |
| Access NMOS (AX) | Bitline과 셀을 연결 |
PD, PU가 Read 시에는 만약 Access 트랜지스터가 너무 강하면 내부 노드의 전압이 올라가다가 SRAM Cell이 0에서 1로 뒤집힐 수 있다. 이는 Read Distrub라 한다.
또한 ,반대로 쓸 때는 내부 상태를 바꿀만큼 충분히 Access 트랜지스터가 충분히 강해야한다. 즉, 모든 트랜지스터가 상대적인 크기와 구동 능력을 조절해야한다는 의미이다.
SRAM을 작게 나눈다면?
실제로, Bank 형식으로 SRAM을 쪼개어 나누는 방법을 자주 사용한다. 다만, 이로인해 아래와 같은 문제가 발생할 수 있다고 한다. 필자는 아래 내용을 완벽하게 이해하지 못했다.
- 주변 회로의 중복: 각 Bank에 Decoder, Sense Amplifier, Precharge 회로 등이 필요해져 면적이 증가한다.
- Global Routing: 어떤 Bank에 접근할지 선택하고 결과를 CPU로 전달하기 위한 배선과 회로가 필요하다.
- 추가 지연: Bank 내부 접근 시간이 줄어도 Bank 선택, 출력 MUX, 긴 Global Wire의 지연이 증가할 수 있다.
- 전력: 일부 Bank만 활성화해서 전력을 절약할 수 있지만, 추가된 배선과 제어 회로도 전력을 소비한다.
그래서 SRAM은 왜 크게 만들면 안되는데?
결국 질문은 여기서 시작했다, SRAM이 좋으면 SRAM으로 모든 걸 만들면 되지 않나. 물론, 돈이 버텨주는 한계에서. 우선 SRAM의 용량을 늘리는 것에 대한 방법부터 정의해보자.
| 방법 | 용량 증가 방식 | 핵심 Trade-off |
|---|---|---|
| ① 셀 미세화 | 동일한 면적에 더 많은 SRAM Cell 배치 | 구동 능력, 안정성, 누설 전류, 제조 편차 |
| ② 배열 확장 | 하나의 SRAM Array에 더 많은 행과 열 연결 | Wordline·Bitline의 정전용량과 지연 증가 |
| ③ Bank 확장 | 작은 SRAM Array를 여러 개 배치 | 주변 회로·배선·Bank 선택 비용 증가 |
결국 설계를 할 때 찾으려는 것은 최적점이다. 어떤 방식을 추가한다 하더라도, 추가적인 회로 비용이 발생하고 적절한 최적점을 찾는 것이 목표다. 접근 시간, 전력, 면적량 등의 총 비용을 줄이는 것이 목표다. 따라서, SRAM을 크게 만드는 것과 모든 데이터를 빠르게 접근하는 것을 동시에 달성하기 어렵다는 사실이 중요하다.
그리고 컴퓨터 공학은 여기서 이러한 한계를 인정하고, L2, L3와 같은 SRAM을 두어 물리적 한계를 인정하고 각 목표에 맞는 계층 구조를 설립하는 것이다. 그리고 여기에는 우리가 배웠던 Temporal Locality와 Spatial Locality라는 중요한 가정이 있다.
References
[1] https://ocw.mit.edu/courses/6-004-computation-structures-spring-2017/pages/c14/c14s1/